项目来源:DeepSeek-AI. DeepInfer: High-performance, large-scale inference framework for DeepSeek models. GitHub. https://github.com/deepseek-ai/DeepInfer(Apache-2.0,2026 年 10 月开源)
前置要求:大模型推理的基本概念(prefill / decode、KV cache、投机解码、MoE 专家并行),对 vLLM 或 SGLang 有初步了解更佳。相关背景可参考大语言模型训练机制全解·第三篇:高效推理与轻量部署核心技术。
1. 引言:推理框架为什么值得自研
1.1 大模型的真实成本在推理侧
训练一个大模型是一次性的"军备开支",推理却是永不停歇的"水电煤"。当模型上线、用户涌入之后,绝大部分算力、电力与资金消耗都发生在推理侧:每一次对话、每一段长文档解析、每一次 Agent 工具调用,背后都是一轮完整的 prefill 加上一串逐 token 的 decode。模型定义了能力的边界,而把这份能力以可承受的成本送到亿万用户面前,才是推理框架要解决的核心问题。
也正因为如此,推理框架早已不是"加载权重、跑个 for 循环"的脚本。在大规模在线服务场景下,它是一个横跨集群的复杂系统:算子内核、集合通信、批调度、缓存管理相互耦合,任何一环的低效都会被每天数十万亿 token 的流量放大成真金白银的浪费。DeepSeek 官方在部署 Q&A 中给出的两个数字很能说明问题:其推理系统单集群每天服务 155 万亿 tokens,整体单位收益约 38 美元/GPU 小时(按谷时定价计)——每一个百分点的吞吐提升,乘上这个基数都是天文数字。
1.2 DeepInfer:DeepSeek 生产系统的开源切片
2026 年 10 月,在陆续开源 FlashMLA、DeepGEMM、DeepEP、TileLang 等一系列推理算子库之后,DeepSeek 迈出了更进一步的一步:把驱动 DeepSeek-V4.1-Flash 大规模云服务的推理框架本体开源,这就是 DeepInfer。它的定位很明确——高性能、面向大规模服务的 DeepSeek 模型推理框架,当前提供离线推理能力,覆盖优化算子内核、DP/CP/EP 并行与 EPLB、DSpark 投机解码、SWA bounded replay、异步调度、批不变性推理与确定性采样、结构化输出等支撑线上服务的核心特性。
开源不到两周,仓库 GitHub star 数已突破 2.3 万。围绕 DeepInfer 本文要回答三个问题:它在架构上做对了什么、核心技术各自解决了什么痛点、普通人能从中借鉴到什么。全文的阅读地图如下:
flowchart TD
    S["DeepInfer 全景导读"] --> A["第 1-2 章 定位与边界:它是什么、开源了什么"]
    S --> B["第 3 章 系统架构:E/P/D 分离、Wide-EP、四个负载均衡器"]
    S --> C["第 4 章 核心技术:算子内核、DSpark、有界重放、异步调度"]
    S --> D["第 5 章 KV Cache:三级存储、命中策略、低精度量化"]
    S --> E["第 6-7 章 上手与性能:构建、评测、Pareto 曲线"]
    S --> F["第 8-9 章 生态与总结:recipe、开源边界、展望"]
2. 项目全景
2.1 开源了什么,又没开源什么
阅读一个开源项目,先看它的边界比先看代码更重要。DeepInfer 的开源清单与非开源清单如下:
| 内容 | 状态 | 说明 |
|---|---|---|
| 推理引擎与模型运行时 | 已开源 | 调度、执行、采样、并行等引擎主体 |
| 算子内核 | 已开源 | 含 TileLang 自研算子与各家算子库的集成 |
| 离线推理入口与示例 | 已开源 | examples/ 下含离线推理、基准测试、结构化输出等 |
| 评测套件 | 已开源 | AIME 2026、HLE、GPQA Diamond 的离线批量评测 |
| deepseek-recipe | 已开源 | 生产级 token 编解码组件(独立仓库) |
| KV cache 存储系统 | 未开源 | 与内部基础设施强耦合 |
| 跨副本负载均衡 | 未开源 | 同上;引擎侧所需功能大多已实现 |
| VE/Prefill/Decode 分离部署 | 未开源 | 引擎功能大多已实现,部署编排依赖内部设施 |
换句话说,DeepInfer 开源的是"单副本内部的一切":从算子到调度器到采样器的完整引擎。那些与 DeepSeek 内部集群编排、3FS 存储深度绑定的"胶水层"暂未公开,但官方在部署 Q&A 与知乎专栏文章《DeepSeek V4.1 Flash 大规模推理部署实践》中给出了相当详细的设计描述,足以拼出全景。
2.2 支持的模型与硬件
模型方面,当前官方支持 DeepSeek-V4.1-Flash,默认检查点为 deepseek-ai/DeepSeek-V4.1-Flash-1017,首次运行时自动下载到 Hugging Face 缓存,也可通过 DEEPINFER_HF_MODEL_DIR 指向本地副本离线运行。官方同时承诺:未来 DeepSeek 模型的推理代码与后续性能优化将持续在 DeepInfer 中开源。
硬件方面实现了真正的双平台支持:
| 平台 | 硬件 | 依赖 |
|---|---|---|
| NVIDIA | SM100 GPU(Blackwell 世代) | CUDA 13 |
| 华为昇腾 | Ascend 950 NPU | CANN 9.2 |
构建环境要求 Linux、GCC 13 及以上、Python 3.12。跨厂商支持并非简单的"移植",从源码目录就能看出用心程度:TileLang 算子下 cuda/ 与 asc/ 两套实现逐一对偶,deep_cluster/hardware/ 里抽象出 nvidia.py / ascend.py / cpu.py 三层设备接口,环境变量 DEEPINFER_ACCELERATOR 在构建与运行时全程生效。
2.3 与 vLLM / SGLang 的渊源
DeepInfer 在致谢中坦诚:项目最初主要构建在 vLLM 之上,同时借鉴了 SGLang 与 TensorRT-LLM 的设计。从源码也能看到血缘关系——sampling_params.py 的文件头就标注着"Derived from vLLM; modified by DeepSeek",API 风格(SamplingParams、LLM 入口、RequestOutput)与 vLLM 高度同构。
但"基于 vLLM"绝不等于"vLLM 的换皮"。阅读 doc/inference_deployment_qa.md 就会发现,DeepSeek 生产系统真正的功夫在 vLLM 未曾覆盖的地带:面向 64 至 128 卡超节点的 Wide-EP 解码、跨 Prefill/Decode/存储节点的 KV cache 复用体系、置信度调度的投机解码、与自家模型架构(YoCo、CED、Engram)深度协同的执行逻辑。可以把 DeepInfer 理解为:以 vLLM 的工程基因为起点,按 DeepSeek 自家模型与自家集群的"身材"重新裁剪、并把生产验证过的优化逐项沉淀下来的推理引擎。
2.4 术语速查
后文会反复出现的缩写先列在这里,可随时回查:
| 缩写 | 含义 |
|---|---|
| E/P/D | Vision Encoder / Prefill / Decode 三级分离部署 |
| VE | Vision Encoder,视觉编码器 |
| SWA | Sliding Window Attention,滑动窗口注意力,query 只看最近窗口内的 key |
| CED | V4.1-Flash 的架构设定:decoder 层的块 KV 由最后一个 encoder 层的隐状态投影而来 |
| YoCo | 把主干层分为 prefill 生产侧与 consumer 消费侧的执行模式,consumer 侧 SWA KV 需逐层计算 |
| Engram | 哈希 n-gram 嵌入机制:压缩词表映射加跨 rank 按哈希汇聚的 n-gram 表 |
| MTP | Multi-Token Prediction,多 token 预测式投机解码 |
| DFlash | 配套的 MTP 草稿模型,内置 Confidence Head |
| DSpark | 置信度调度的变长投机验证方案 |
| Wide-EP | 把 MoE 专家并行扩展到 64 至 128 卡规模的解码并行策略 |
| EPLB | Expert-Parallel Load Balancing,专家并行负载均衡 |
| GDR | GPUDirect RDMA,网卡直接读写 GPU 显存 |
3. 系统架构:分离式 E/P/D 与 Wide-EP
3.1 三大设计目标
DeepSeek V4.1-Flash 推理系统从立项之初就锚定了三个目标,它们直接决定了架构形态:
- 多厂商加速卡支持:同一套框架跑在 NVIDIA 与昇腾之上,并榨干各自硬件的性能。
- 围绕商用硬件组织 Prefill 与 Decode:Prefill 用普通 8 卡机器,Decode 用普通的 64 至 128 卡超节点,计算、通信、调度都围绕两个阶段的负载特性分别设计。
- KV cache 保留超过 72 小时:给上下文复用留出更长的窗口,缓存命中时直接省掉重复的 prefill 计算,同时消化长保留期带来的容量与管理开销。
3.2 参考架构总览
围绕上述目标,生产系统采用分离式 E/P/D 架构(Vision Encoder / Prefill / Decode 三级分离)外加专用存储节点的总体形态:
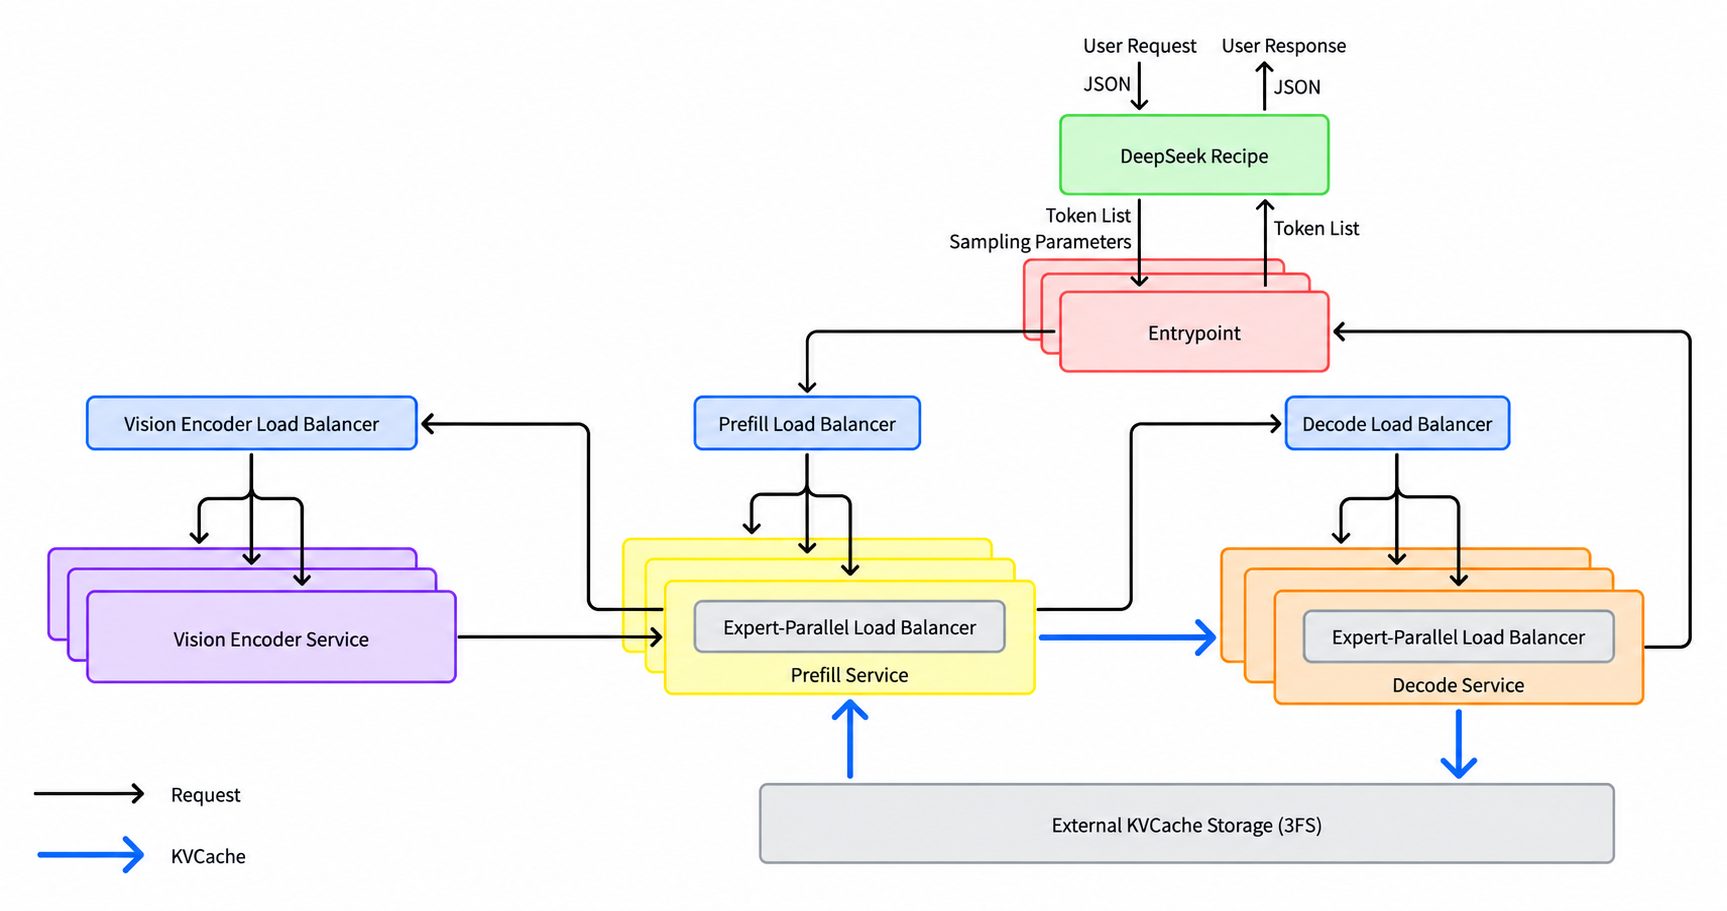
一张图里包含了五类关键组件:
- Vision Encoder(VE):独立部署的视觉编码器,单卡实例即可,推荐用便宜的 GPU。
- Prefill Engine(PE):处理 prompt 的计算密集阶段,独立扩缩容。
- Decode Engine(CE):逐 token 生成的访存密集阶段,用大规模 EP 摊薄访存。
- 四类负载均衡器:Prefill LB、Decode LB、VE LB、Expert-Parallel LB,分别对齐四种并行维度。
- KVCache 存储:基于 3FS 的独立存储集群,让任意 Prefill 机器都能命中任意前缀。
请求进出系统还要经过 DeepSeek Recipe 这一层:把 Chat Completions、Responses、Messages 等主流 API 协议高效、准确地转换为模型 token 序列,处理逻辑与官方 DeepSeek API 完全对齐,第三方部署因此能获得与官方一致的 API 行为。
3.3 并行策略:DP + EP 与 Wide-EP
沿用 DeepSeek-V3 / R1 推理系统的思路,Attention 部分采用数据并行,且 #DP = #EP,DP/EP 副本之间必须做负载均衡。两个阶段的并行规模选择几乎相反:
| 阶段 | 并行配置 | 选择逻辑 |
|---|---|---|
| Prefill | EP 2 至 8 / DP 2 至 8 | HBM 允许的最小 EP/DP |
| Decode | EP 64 至 128 / DP 64 至 128(Wide-EP) | 可用 GPU 允许的最大 EP/DP |
| VE | 单 GPU 单实例 | 便宜卡即可 |
| TP / CP | 生产中暂不使用 | Attention DP 已覆盖需求 |
Decode 选择 Wide-EP 的理由很实际:大规模专家并行能大幅降低 MoE 部分每步的显存访存流量,配合良好的 EPLB 支撑,可以有效抬高 TPS。官方给出了 EP8 与 EP64 的对比基准:
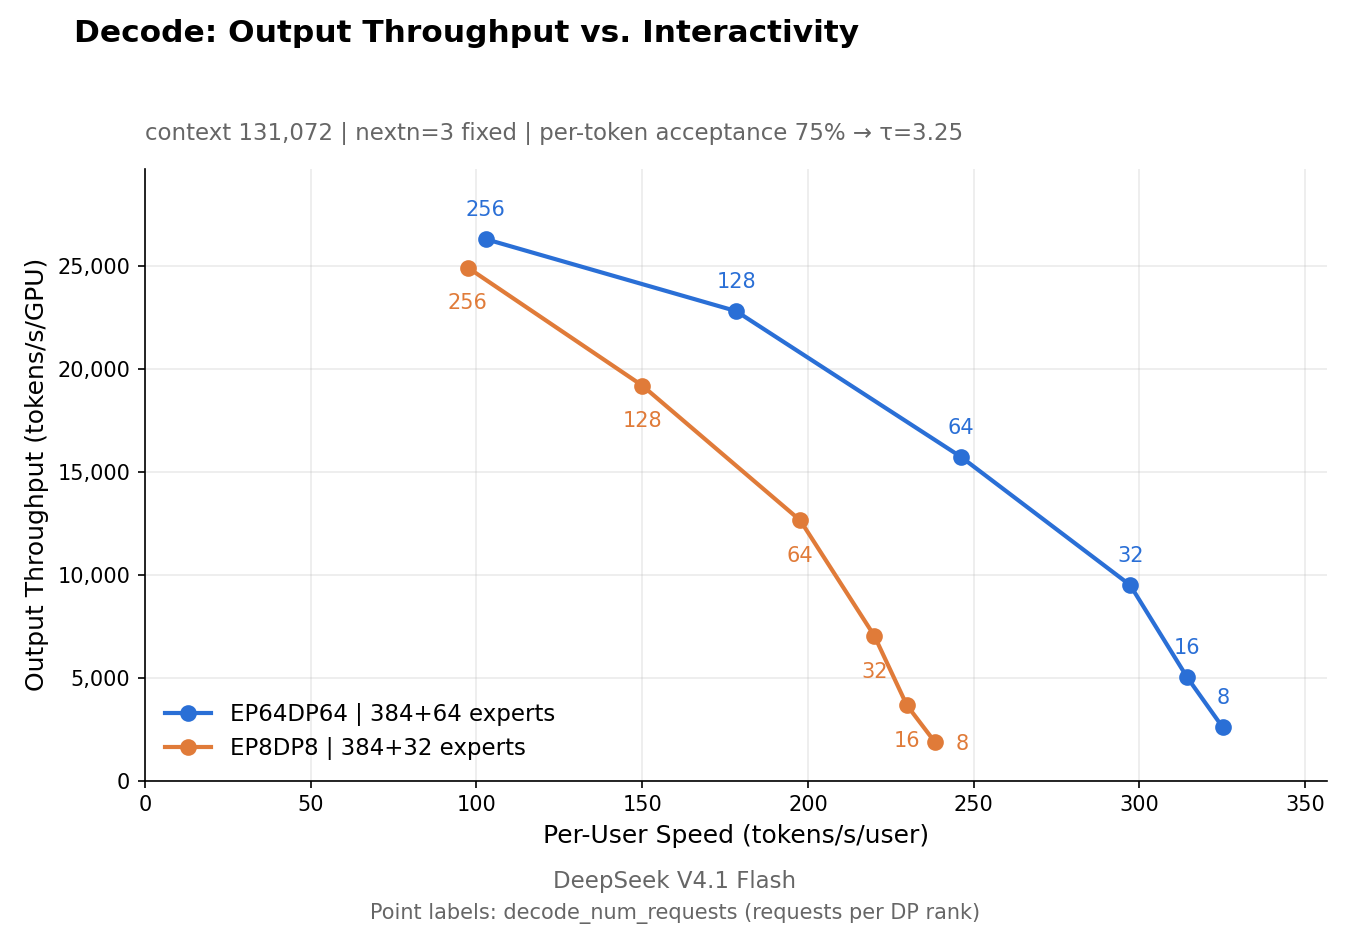
部署粒度上,1P + 1D 即可跑通,实践中 P 与 D 的 GPU 配比约为 1:1;由于推荐解码配置是 EP64 及以上,最小高效部署单元约为 64 卡 Prefill + 64 卡 Decode。多模态走 EPD 分离,视觉编码器单卡部署。跨数据中心部署在技术上可行(V4.1-Flash 对 KV cache 做了大幅压缩),每 8 卡约需预留 400 Gbps 互联带宽;DeepSeek 自己的推理节点就部署在相邻的不同数据中心。
3.4 负载均衡:四个维度同时发力
大规模分布式推理里,“木桶效应"无处不在:只要有一个 GPU 慢了,整步就得等它。DeepSeek 用四个专职负载均衡器分别治理四类不均衡:
| 负载均衡器 | 治理对象 | 核心机制 |
|---|---|---|
| Prefill LB | 请求的上下文长度差异 | 按长度分 4 桶(小于 16K / 16 至 64K / 64 至 256K / 不小于 256K),按算力配额动态调配引擎;组内按配额拉活,无前缀亲和路由 |
| Decode LB | 请求数与 KV 总长的双重不均衡 | 全 GPU 均匀路由,短请求发往并发低但 KV 长的 GPU,长请求发往 KV 短的 GPU |
| VE LB | 图片计算量差异 | 按机器粒度路由,机器内挑当前 patch 数最少的 GPU |
| EPLB | 专家热度不均 | 冗余专家 + 周期性统计再分配,权重经 NVLink symm_mem 组内重排 |
其中 Prefill LB 的细节最能体现"工程的精细度”:单 GPU 内请求按 FIFO 出队,但 chunk 大小不是固定的——每一步 prefill 都有一个时间预算(compute_quota_limit,纳秒级),一个拟合好的二次代价模型 $cost(q, c)$($q$ 为本步序列 token 数,$c$ 为已算好的前缀长度)预测本步耗时,调度器在 32,768 token 的上限内解出恰好用完时间预算的最大 $q$,预算本身还会在 DP 组内做一次 all-reduce MIN 对齐。
EPLB 的实测效果用 moe_lb(最慢 rank 除以平均值)衡量:Prefill 场景(EP4DP4 / EP2DP2)为 1.074 / 1.045,Decode 场景(每卡 1 个冗余专家起步,1000 步统计窗口、每 10,000 步重分配)为 1.090。整体上,这套负载均衡让在线系统达到了完美均衡离线基准约 80% 的水平——在生产环境里这是相当可观的数字。
3.5 弹性伸缩与容错
扩缩容的信号源与两个阶段的负载特性严格对应:Prefill 按非缓存 token 数决定机器数,Decode 按运行中请求数调整,调整过程有速率限制与上下限保护。针对长尾请求在大 EP 部署下的资源浪费,被通知下线的 Decode 引擎会进入 1 分钟的宽限期,把未完成请求连同 KV cache 一次性转发给其他引擎继续解码。
容错思路同样务实:不做"秒级重启",而是靠配额冗余 + 请求级重路由扛住故障(重启是分钟级的);配额利用率高于 0.8 时禁止缩容,池中常备空闲机器作为扩容库存。大 EP 部署下一张卡坏掉会让整个通信域不可用,平台会根据剩余健康 GPU 数重新确定 EP 规模,实例拿到几张健康卡就以几张卡的 EP 继续服务。
4. 核心技术拆解
4.1 高性能算子内核
一切上层优化都建立在算子够快的前提下。DeepInfer 集成了 FlashMLA、DeepGEMM、DeepEP、TileKernels、DeepSelect 等算子库,但比起罗列阵容,更值得看的是 TileLang 自研算子的组织方式:deepinfer/model_executor/layers/tilelang_ops/ 下 cuda/ 与 asc/ 两套实现逐一对偶,各自覆盖了从 load_paged_kv_cache、store_kv_cache、融合采样(fused_sample)到 MTP 变长调度(schedule_mtp_varlen)等几十个算子,很多是把多个小算子融合成一个大 kernel,减少显存往返与 kernel launch 开销。官方在 Q&A 中也坦率地对比了内外部版本:开源版 DeepGEMM / FlashMLA 与内部版本大体一致,FlashMLA 缺一处手工调优的 SASS 优化导致解码内核慢 5% 至 10%,端到端差距最多 5%。
MoE 路径上的"Mega MoE"融合算子被描述为 scale-up 域内的通用解:无论 EP 规模与批量大小,都显著快于未融合的 MoE 实现。此外 graph_timer、flops_estimator、CUDA Graph 支持(cuda_graph_runner.py)等基础设施一应俱全,性能剖析可通过 examples/benchmark.py 的 PROFILE=1 导出含内核构成的 trace。
4.2 DSpark:置信度驱动的投机解码
投机解码的常识是:草稿模型一次猜多个 token,目标模型一次性验证。问题在于,每个草稿 token 被接受的概率天差地别——固定验证 5 个 token,等于把大量验证算力浪费在大概率被拒的位置上。
DSpark 的解法是把"验证多长"变成一个调度问题:
flowchart TD
    A["草稿模型一次生成 5 个候选 token"] --> B["Confidence Head 预测每个 token 的接受概率"]
    B --> C["按接受率对候选 token 排序"]
    C --> D["结合实测的硬件吞吐曲线选择验证前缀"]
    D --> E["目标模型执行变长验证"]
    E --> F["接受通过的 token 并丢弃被拒 token"]
实现上,草稿模型(DFlash)内置一个 Confidence Head:以隐状态(加可选的马尔可夫嵌入)为输入,经一个线性投影加温度标定,输出每个位置的接受概率预测。调度时,把候选 token 按期望接受率排序,截取使有效吞吐最大的前缀子集送验。生产配置下草稿模型每次出 5 个 token,变长验证的效果相当直观:
| 并发(seqs/rank) | 固定-5 验证长度 | 变长验证长度 | 固定-5 接受长度 | 变长接受长度 | 吞吐增益 |
|---|---|---|---|---|---|
| 16 | 5.00 | 4.44 | 3.32 | 3.24 | -1.5% |
| 60 | 5.00 | 3.58 | 3.30 | 3.21 | +5.4% |
| 96 | 5.00 | 3.24 | 3.30 | 3.15 | +11.0% |
平均每步验证 token 数从 5.00 降到 3.2 至 3.4(省下约 30% 的验证算力),而平均接受长度几乎不动(3.29 对 3.20)。在生产工作点(每 rank 约 60 并发)折算出 4% 至 5% 的吞吐提升,高并发时最高超过 10%。低并发时变长验证略有负收益(-1.5%),这也符合直觉:并发低、验证算力不紧张时,省下的验证量换不回排序调度的开销。
与异步调度的配合值得一提:schedule(N+1) 执行时,第 N 步的置信度还没从 GPU 返回,因此 CPU 调度只锁定总预算,各请求的具体草稿长度由 GPU 侧的一个 TileLang 内核(累计乘积、全局排序取 top-k、融合重映射散写)实时算出并写回锁页缓冲。
4.3 SWA bounded replay:把重算开销压成常数
长上下文服务里最贵的计算之一是重算:缓存缺失时,传统做法往往要把相当长的前缀重新过一遍网络。V4.1-Flash 的模型架构里有两个关键设定——滑动窗口注意力(SWA)与 CED 架构(decoder 层的块 KV 由最后一个 encoder 层的隐状态投影而来)——SWA bounded replay 正是吃透这两个设定后的产物。
核心思想一句话:重算只做最后 128 个 token,且把注意力窗口截断在重放段内。从位置 $s$ 开始重放时,位置 $i$ 的 query 只对 $\max(s, i - 127)$ 到 $i$ 的 key 计算注意力,得到近似的 SWA KV。这样一来,重算开销被压成与上下文长度、层数都无关的常数。该机制用在两处:
- Encoder 侧有界重放:前缀命中长度只取决于块 KV cache;SWA KV 缺失时,把命中前缀的末尾 128 个 token 重算一遍,与未缓存后缀一起前向,重放段只重建 SWA KV,块 KV 原样复用。
- Decoder 侧有界重放:CED 架构下 decoder 层的块 KV 可由末层 encoder 隐状态投影得到,真正需要逐层计算的只剩 decoder 的 SWA KV。精确重建本要把最后 2,560 个 token 过 20 个 decoder 层,有界重放改为只重算末尾 128 个 token,且结果仅用于本次解码、不进前缀缓存——prefill 总计算量近乎减半。
对应的开关是 DEEPINFER_YOCO_PREFILL_TRUNCATION_MODE=compact 与 DEEPINFER_YOCO_PREFILL_KEEP_TOKENS=140(V4.1 默认配置):YoCo consumer 层的 prefill 被截断,保留的末尾后缀必须覆盖 SWA 窗口加最大回溯长度。命中策略的完整决策流程如下:
flowchart TD
    A["输入序列长度 L"] --> B["命中上限封顶为 L - 134"]
    B --> C["查询块 KV cache 得到命中长度 L1"]
    C --> D{"L1-128 到 L1 区间存在 SWA KV"}
    D -->|"是"| E["最终命中长度取 L1"]
    D -->|"否"| F["回退一个块取 L1 - 128"]
    F --> G["重算末尾 128 个 token"]
其中 134 = 128 的滑窗 + 6 个投机回溯 token,128 为块粒度与重算窗口。规则可以概括为:命中长度由块 KV 决定,末块要不要重算由 SWA KV 决定。
4.4 异步调度:零开销批调度器
解码的一个 step 天然包含四种工作:schedule(N) → forward(N) → sample(N) → post-process(N)。其中 schedule 与 post-process 是纯 CPU 逻辑,而 post-process 又必须拿到 sample 的结果,被迫与 GPU 同步。于是每个 step 里 GPU 都要干等 CPU 做完这两段。
异步调度(借鉴 SGLang、NanoFlow 的思路)用流水线把这段空转抹掉:GPU 跑 forward(N) → sample(N) 的同时,CPU 并发执行 schedule(N+1) → launch_forward(N+1) → post-process(N-1) → launch_sample(N+1):
GPU:  |  forward(N)   |   sample(N)  |  forward(N+1)  |  sample(N+1) | ...
CPU:  | schedule(N+1) → launch_forward(N+1) | post-process(N-1) → launch_sample(N+1) | ...
全程 GPU 无空闲。该特性默认开启,是 README 中"zero-overhead batch scheduler"的所指。
4.5 批不变性推理与确定性采样
推理结果的可复现性在评测、调试与合规场景下价值极高,但实践起来非常难:批量组成一变,浮点归约顺序就变,输出跟着变。DeepInfer 提供两个相关特性:
- 批不变性推理:
DEEPINFER_BATCH_INVARIANT=1(仅 NVIDIA),保证不同批量组合下模型结果完全一致。 - 确定性采样:相同输入 token 与采样参数产生相同输出,需同时满足
DEEPINFER_BATCH_INVARIANT=1、DEEPINFER_ENABLE_MTP_VARLEN=0,并为SamplingParams传入固定的seq_seed。
SamplingParams 的设计也呼应了这一点:seq_seed 是显式的一等参数,缺省时随机生成 64 位种子;官方测试里还有专门的 test_batch_invariant.py 回归用例,把"批量变了结果不能变"钉死在 CI 里。
4.6 结构化输出
Agent 与工具调用场景要求输出严格符合 JSON Schema、正则或 EBNF 文法。DeepInfer 的结构化输出采用编译与推理解耦的架构:
- 编译阶段:在专用的 SO 机器上把格式约束编译成文法自动机,异步完成;请求进入引擎前取回编译结果。
- 运行阶段:每步解码推进自动机,算出合法 token 集合并生成 mask,施加到采样逻辑上,强制输出符合目标结构。
API 上通过 SamplingParams 的 so_args={"schema_type": ..., "schema": ...} 传入,还支持 trigger_token_ids(触发文法生效的 token 序列)与 bound_token_id 等精细控制。缓存、超时、构建并发都有对应环境变量(DEEPINFER_XGRAMMAR_*、DEEPINFER_SO_BUILDER_CPUS),工程完成度可见一斑。
5. KV Cache 体系:72 小时上下文复用
如果说算子与调度决定"跑多快",KV cache 体系就决定"能省多少"。DeepSeek 为 V4.1-Flash 制定的目标是 KV cache 保留超过 72 小时,靠长窗口的上下文复用砍掉重复 prefill——这是一套贯穿显存、主机内存、SSD 集群的分层体系。
5.1 三级存储布局
| 内容 | 存储介质 | 副本策略 | 管理方 |
|---|---|---|---|
| 在途块 KV + 状态 KV | 推理 GPU 显存 | — | Prefill / Decode 实例 |
| SWA KV | 本地主机内存 | 单副本,不上 3FS | Prefill / Decode 实例,跨机经 400G VLAN 拉取 |
| 分页块 KV | 专用 3FS 存储集群 | 无应用层副本,依赖 3FS 自身冗余 | kvcache-store |
几个设计取舍值得细品:
- 块 KV 放独立存储集群而非本地分层缓存:让任意 Prefill 机器都能命中任意前缀,避免"前缀亲和"与"负载均衡路由"打架;存储节点与计算节点解耦扩缩容;且计算节点故障率比存储节点高一个数量级以上,KV 不受其牵连。
- Prefill 侧同样使用分页 KV cache;Decode 侧不做 KV offload(解码不受缓存容量约束),但产出的 KV 仍写盘以提升命中率。
- 存储集群:3FS 以 10+2 纠删码存储,一个 EC 组可容忍两台存储节点同时故障,读请求并发发给组内 11 个节点、任意 10 个响应即可返回;单机盘数与吞吐、每卡容量配比等硬件规格见部署 Q&A 原文。
- 保留策略:3FS 提供约 100 PiB 的 SSD 空间,TTL 按流量区分——Agent 流量 3 天、Chatbot 流量 7 天。Chatbot 的命中长尾极重(少量 KV 被反复读取),实测 TTL 从 7 天缩到 3 天会让 Chatbot 命中率掉 0.5% 至 1%。回收交给 3FS 的 GC Worker,按 LRU 淘汰到水位线以下。
缓存相关的开销也做了重叠设计:匹配在入口侧对本地 kvcache-store 做纯元数据的哈希链前缀匹配(命中长度要在路由前算出,无法隐藏);取 KV 由独立进程异步从 3FS 搬进主机共享内存;换入(swap-in)在引擎进程内用线程做,逐层 H2D 传输与前向计算重叠。由于 CUDA 拷贝引擎处理细粒度 KV 块拷贝效率不佳,换入用 GDR 实现——RDMA 网卡打满 PCIe 带宽且不占用 SM。
5.2 命中与重算策略
命中策略在 4.3 节已有决策图,这里补充两点系统级考量。其一,命中长度的封顶 L - 134 源于 YoCo 截断的硬约束;其二,SWA KV 缺失时"回退一个块并重算 128 token"的代价是常数级的,这让"块 KV 命中 + SWA KV 大概率缺失"这种半命中状态变得可以接受,大幅放宽了对 SWA KV 命中率的要求。
SWA KV 本身的管理也有讲究。它不进持久化缓存,只留在产出它的机器的内存里;一份逻辑统一、物理按 key 分片的内存目录(分布在入口机上)记录谁持有它,跨机命中时再经 400G VLAN 拉回。SWA KV 以 128 token 的粒度落盘到主机内存:prefill 结束时按 128 对齐取整存储(不足一个单元则不存),decode 阶段每越过一个 128 边界就把当前窗口拷贝到设备端副本区,请求结束时取最近一次完整副本落存。每序列落存的只有 state_size_to_disk = 20 层 × 134 token × 528 字节(MXFP8 格式)= 1,415,040 字节,压缩比相当可观。
5.3 低精度量化
KV 与权重的低精度化是容量与带宽的双重红利,V4.1-Flash 推理系统的量化配置如下:
| 对象 | 量化格式 | 分组粒度 |
|---|---|---|
| 主 KV | e4m3(类似 NVFP4,无全局 scale) | 每 16 个 |
| Indexer KV | ue8m0,MXFP4 | 每 32 个 |
| MoE 路由专家权重 | ue8m0,MXFP4 | 每 32 个 |
SWA KV 则采用 MXFP8 格式(528 字节/token)。量化、反量化与尺度打包都有对应的 TileLang 算子(如 kv_quant.py、quant.py、_pack_ue8m0_to_int),在内核层面消化了低精度格式的额外元数据开销。
6. 上手指南
本章按官方 README 整理最小可用路径。注意 DeepInfer 的定位是大规模推理框架,没有 GPU 也可以读懂,但跑起来需要相当规模的硬件(最小高效部署单元为 64 卡 Prefill + 64 卡 Decode;离线示例可在单机多卡上运行)。
6.1 环境要求与构建
| 项目 | 要求 |
|---|---|
| 操作系统 | Linux |
| 编译器 | GCC 13.0 及以上 |
| Python | 3.12(建议使用干净的空环境) |
| NVIDIA 平台 | CUDA 13 |
| 昇腾平台 | CANN 9.2 |
构建入口是仓库根目录的 build.sh,加速卡类型通过环境变量指定,且在运行时也要保持导出:
# 昇腾平台改用 export DEEPINFER_ACCELERATOR=ascend
export DEEPINFER_ACCELERATOR=nvidia
./build.sh
build.sh 会安装依赖并构建 vendor 算子与树内的 DeepInfer C++ 扩展。源码构建之外,仓库还提供 Makefile、scripts/build.sh 等辅助脚本,测试用 python -m pytest -v -s tests。
6.2 离线推理
默认检查点 deepseek-ai/DeepSeek-V4.1-Flash-1017 首次运行自动下载;本地有副本时用 DEEPINFER_HF_MODEL_DIR 指过去即可完全离线。最小示例:
python examples/offline_inference.py --ep 8
python examples/offline_inference.py --ep 2 --dp 8
python examples/offline_inference.py --ep 2 --cp 8
示例默认开启批不变性(NVIDIA)与 EPLB,跑完打印每条样本的输出、投机接受率(accept_rate)与解码困惑度(decode_ppl)。加 --check_structured_output 可在同一实例上顺带校验正则、JSON、EBNF 三种结构化输出与正常 EOS 终止。VL 示例所需的图片与 prompt 都内置在仓库里,不依赖外部缓存。
采样侧的 API 与 vLLM 同构,结构化输出与确定性采样的用法示意:
from deepinfer.sampling_params import SamplingParams

params = SamplingParams(
    temperature=0.7,
    max_tokens=256,
    seq_seed=42,  # 固定种子,配合批不变性实现确定性输出
    so_args={"schema_type": "json", "schema": '{"type": "object"}'},
)
调节系统行为的环境变量相当丰富,常用的几个:
| 环境变量 | 默认值 | 作用 |
|---|---|---|
DEEPINFER_USE_NEXTN_DECODE | 5 | 投机解码最大草稿长度,设 0 关闭 |
DEEPINFER_ENABLE_MTP_VARLEN | 关 | DSpark 变长验证 |
DEEPINFER_YOCO_PREFILL_TRUNCATION_MODE | off | YoCo 截断模式(mask / compact) |
DEEPINFER_YOCO_PREFILL_KEEP_TOKENS | 0 | 截断时保留的末尾 token 数(V4.1 用 140) |
DEEPINFER_BATCH_INVARIANT | 关 | 批不变性推理(仅 NVIDIA) |
DEEPINFER_OVERRIDE_NUM_EXTRA_EXPERTS | 32 | EPLB 冗余专家数下限 |
7. 性能与评测表现
7.1 基准测试与 Pareto 曲线
examples/benchmark.py 将 prefill 与 decode 两阶段解耦测量,稳态指标包括 prefill 吞吐(tokens/s/GPU)、decode 平均 SPS(steps/s)与 decode 吞吐:
其中 $B$ 为解码批量,$\text{nextn}$ 为投机草稿长度,按满接受率口径统计。基准测试有严格的预热与测量窗口设计(丢弃与负载均衡统计刷新碰撞的区间等),并支持 PROFILE=1 导出含内核构成的 trace;examples/sweep/ 下的脚本可扫描批量参数、绘制吞吐-延迟 Pareto 曲线。
官方基准在 4 张 SM100(Prefill)与 64 张 SM100(Decode)上测得,各自位于同一 scale-up 域内,复现脚本为 examples/sweep/run_sweep.sh:
| Prefill 吞吐-延迟 | Decode 吞吐-单用户速度 |
|---|---|
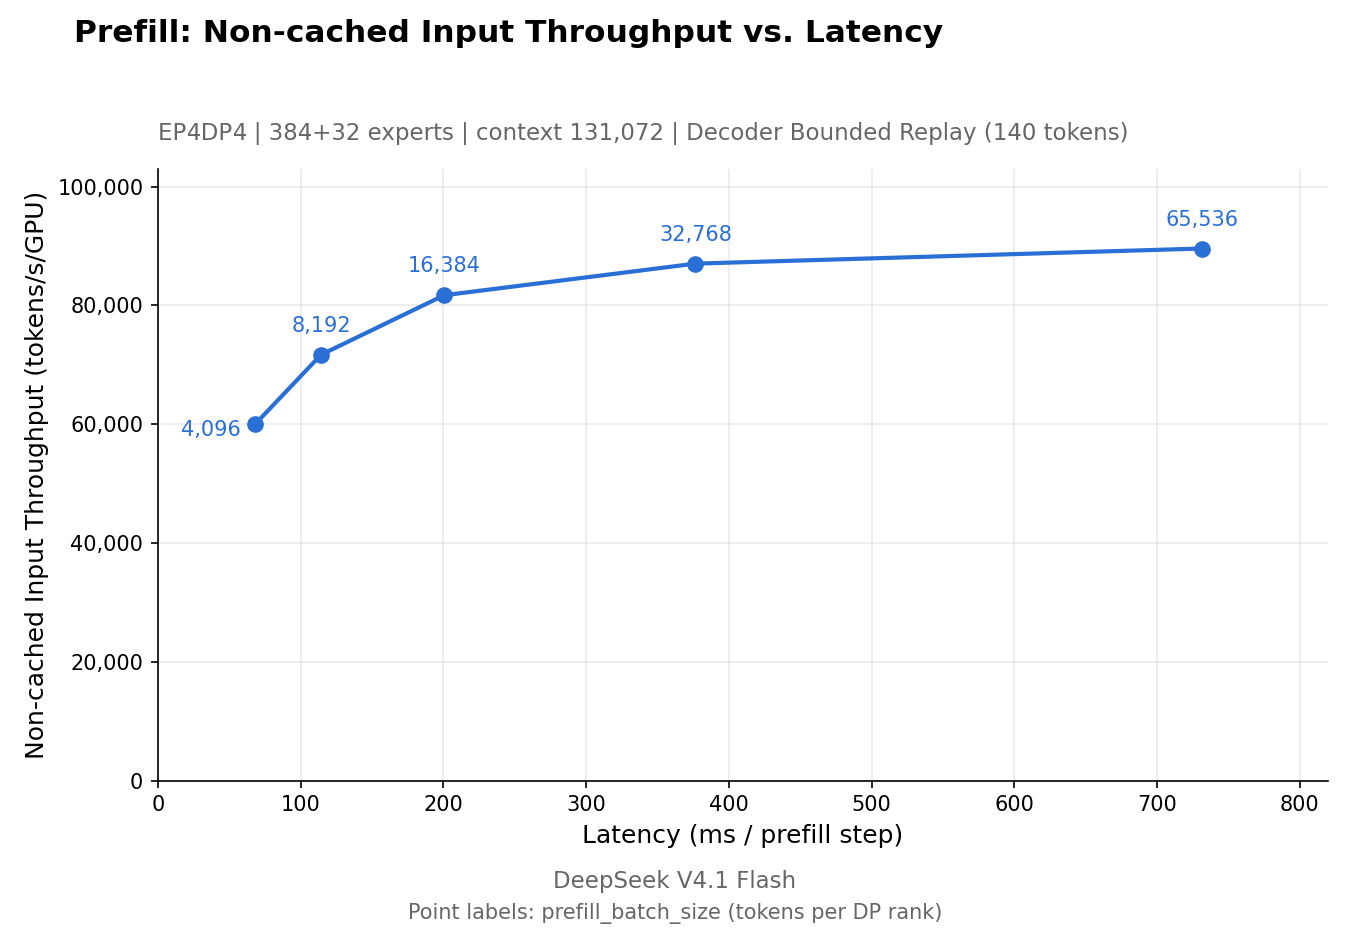 | 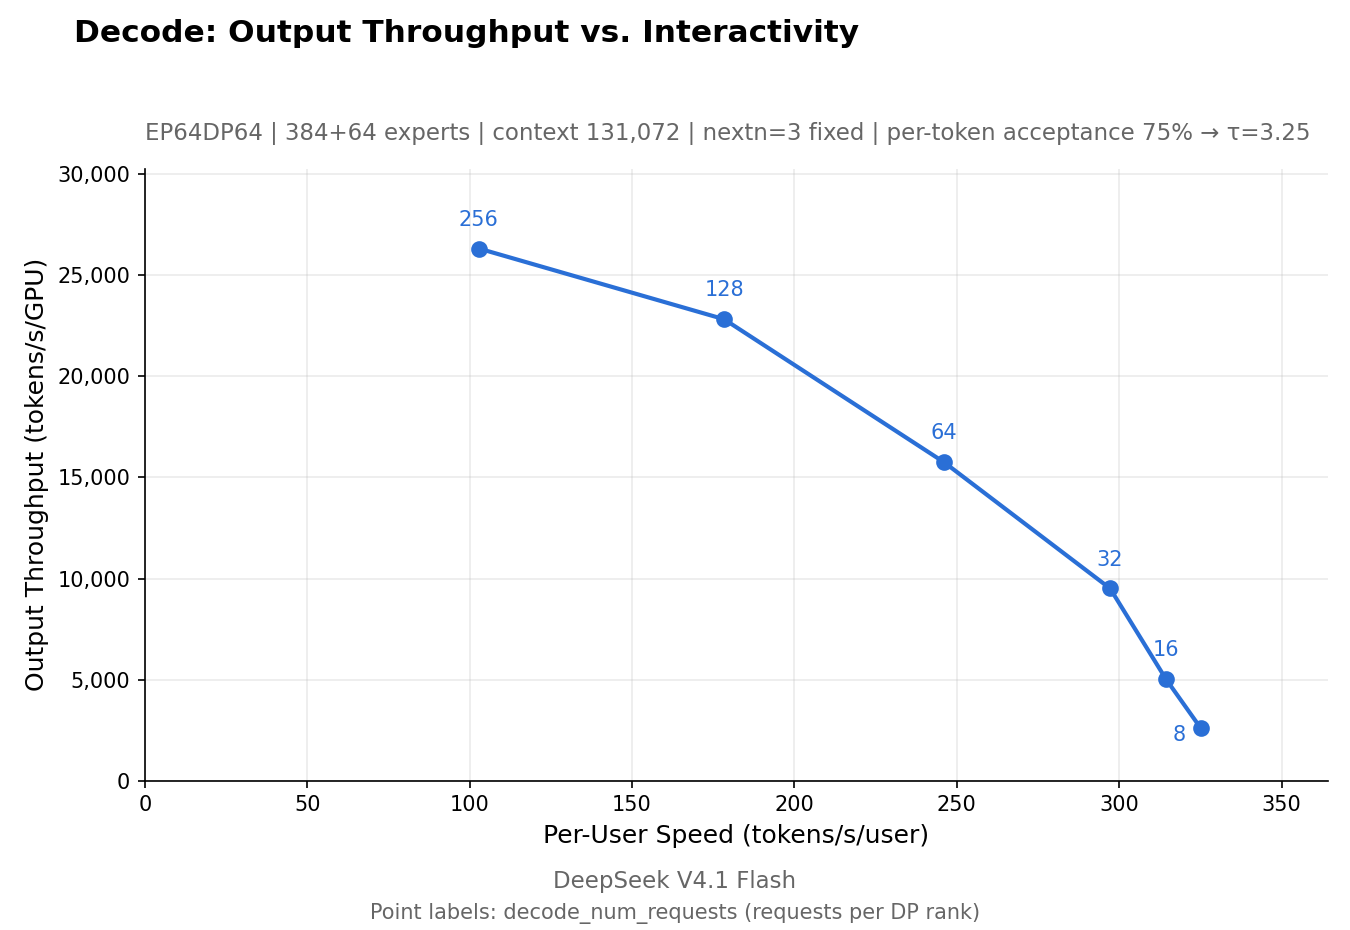 |
Pareto 曲线的读法是:同一条曲线上的点代表不同的批量配置,越靠"右上"(吞吐高、延迟低)越好。结合 3.3 节的 Wide-EP 对比图可以看出,在线服务的配置选择本质上是在"单用户速度"与"集群总吞吐"之间找平衡点,而 DeepInfer 的调度器、EPLB 与投机解码都在把这个前沿往外推。
7.2 模型能力参考成绩
eval/ 目录提供 AIME 2026、HLE、GPQA Diamond 的离线批量评测,生成与打分两阶段分离,支持 LLM judge 与规则 judge 两种模式,指标为 Pass@1。官方给出的参考成绩如下,可作为部署正确性的 sanity check(生成存在随机性,重复运行会有小幅波动):
| 基准 | Pass@1 |
|---|---|
| AIME 2026 | 99.9% |
| GPQA Diamond | 93.4% |
| HLE-Full | 42.6% |
评测管线本身也是开源的一部分:数据需自行从上游来源(MathArena、cais/hle、gpqa 等)获取并转成 JSONL,AIME 与 GPQA 支持多采样(默认 32 / 8 次),HLE 为单采样且仅支持 LLM judge。打分与生成分离的设计,意味着换 judge 重新打分不必重新生成。
8. 生态、边界与展望
8.1 周边开源:deepseek-recipe 与算子家族
与 DeepInfer 同步开源的还有 deepseek-recipe:生产级的 token 编解码组件,在主流 LLM API 协议与模型 token 序列之间高效、准确地互转,处理逻辑与官方 DeepSeek API 完全对齐,核心路径用 Rust 实现并配 Python 绑定。两个亮点值得一提:一是防注入——显式插入的特殊 token 按位置直接映射 ID,用户输入里形似控制标记的文本一律按普通 token 序列编码,输出侧按 token ID 识别结束标记,模型"手打"出来的同名文本保持为字面内容;二是吞吐与延迟优化——普通文本段在特殊 token 边界之间并行编码后拼回,显著降低超长上下文的 tokenize 延迟,流式解析用状态机跨 chunk 缓冲 UTF-8 字符、增量匹配分隔标记,工具参数边生成边输出 JSON 片段,尽量缩短首个响应片段的等待时间。
算子层面,DeepSeek 此前已开源 TileLang 与 FlashMLA、DeepGEMM、DeepEP、TileKernels、DeepSelect 等内核库,DeepInfer 把它们与自研 TileLang 算子整合成完整的执行栈。工具链周边还有 3FS(分布式文件系统)支撑 KV cache 存储。可以说,DeepSeek 已经把推理系统从算子、引擎、编解码到存储的整条链路都部分开放了。
8.2 开源边界与后续演进
诚实地看待边界:KV cache 管理与跨副本负载均衡因与内部基础设施强耦合暂未开源,完整的 VE/P/D 分离部署编排也依赖内部设施。这意味着开源版 DeepInfer 的"完全体"形态需要自己补上服务化层——但引擎内部的绝大多数功能(包括分离部署所需的引擎侧逻辑)已经就绪。
官方明确承诺:未来 DeepSeek 模型的推理代码与后续性能优化将持续开源进 DeepInfer,部署 Q&A 文档也会持续更新。对社区而言,这个仓库的价值至少有三层:
- 可复现的生产级推理代码:读懂 Wide-EP、EPLB、变长投机验证、有界重放在真实系统里如何落地,最好的教材就是生产代码本身。
- 可直接复用的工程组件:批不变性测试、PPL 基线回归、结构化输出管线、基准测试框架,抽出来即插即用。
- 双平台实践样本:CUDA 与昇腾算子逐一对偶的组织方式,对做国产卡适配的团队很有参考价值。
9. 总结
DeepInfer 是一份难得的"生产系统切片"。它没有停留在"又一个推理框架"的层面,而是把 DeepSeek 服务每天 155 万亿 token 时沉淀下来的方法论完整地摊开:用分离式 E/P/D 解耦资源、用 Wide-EP 摊薄解码访存、用四个负载均衡器治理四类不均衡、用 3FS 三级缓存体系把上下文复用窗口拉长到 72 小时以上,再用 DSpark 变长投机验证、SWA bounded replay、零开销异步调度这些"毫米级"优化一点一点把吞吐前沿往外推。
从 vLLM 的工程基因出发,经过自家模型架构(YoCo、CED、Engram、DFlash)与自家集群的双重淬炼,DeepInfer 最终呈现的是一个为大规模、低成本、多硬件平台推理而生的引擎。无论你是想部署 DeepSeek-V4.1-Flash、研究推理系统的工程细节,还是为国产加速卡寻找适配范式,这个仓库都值得克隆下来逐文件细读。
最后用官方部署 Q&A 的开篇一句话作结:
A model defines the boundary of what is possible; serving those capabilities to a massive user base at a reasonable cost is the core problem an inference framework has to solve.
—— DeepSeek-AI. DeepSeek V4.1 Flash Inference Deployment Q&A
模型定义了可能的边界,而推理框架决定多少人用得起这份可能。那些藏在调度器、缓存与算子里的毫米级优化,最终都会变成另一个人敲下问题后少等的那几秒,和一张更低的账单——这大概是这门工程最朴素的意义。
参考资料
- DeepSeek-AI. DeepInfer: High-performance, large-scale inference framework for DeepSeek models. https://github.com/deepseek-ai/DeepInfer
- DeepSeek-AI. DeepSeek V4.1 Flash Inference Deployment Q&A. doc/inference_deployment_qa.md
- DeepSeek-AI. Examples. examples/README.md
- DeepSeek-AI. Benchmark evaluation. eval/README.md
- DeepSeek-AI. deepseek-recipe. https://github.com/deepseek-ai/deepseek-recipe
- DeepSeek-AI. DeepSeek V4.1 Flash 大规模推理部署实践. https://zhuanlan.zhihu.com/p/2095560295930508953
- DeepSeek-AI. DeepSeek-V3 / R1 推理系统(知乎专栏). https://zhuanlan.zhihu.com/p/27181462601