论文来源:Karan, A., Chen, S., & Du, Y. (2026). Finetuning with Sampling: SFT Learns Better Than You Think. arXiv:2610.02140. arXiv 页面 · 项目主页 · 代码(CC BY 4.0)
前置要求:SFT 与 RL 后训练的基本概念(交叉熵损失、on-policy 与 off-policy、灾难性遗忘),KL 散度。MCMC 不要求预先了解,正文会做轻量铺垫。
1. 引言:SFT 的坏名声与 RL 的免死金牌
1.1 后训练的两难
给前沿大模型引入新能力,今天的主流答案是强化学习(RL)。大量证据表明:RL 学新任务时泛化更强,还很少损伤模型原有的能力;而监督微调(SFT)则背负着两大罪名,泛化弱(容易死记训练集)与灾难性遗忘(学了化学,数学就不会了)。社区甚至流传着一句话级别的结论:“SFT memorizes, RL generalizes”。
两种范式的差距被归因于数据的"来路":RL 是 on-policy 的,模型用自己的采样驱动学习,天然不会偏离起点太远;SFT 是 off-policy 的,专家数据想怎么写就怎么写,模型被迫追逐一个离自己很远的分布,梯度又大又不稳,过拟合与遗忘随之而来。
但换个角度想,off-policy 也有不可替代的好处:专家轨迹带着特权信息,那些模型自己根本采不出来的正确解法。对"引入全新能力"这个目标来说,这恰恰是最宝贵的监督信号。
1.2 on-policy 的软肋:难题上没有学习信号
严格 on-policy 的代价同样刺眼。RL 靠模型反复采样来撞出成功轨迹:如果一个训练样本太难,模型怎么采都采不出正确答案,奖励没有方差,就没有学习信号。这些样本等于被白白丢弃。已有工作在实践中观测到相当规模的"难样本弃疗区"。
对于引入新能力的场景,这个缺陷是致命的:新能力之所以"新",就是因为模型现在还不会,还采不出成功轨迹。此时 SFT 的优势就出来了。它直接消费专家构造的轨迹,不需要显式奖励,也能提供密集的监督信号。
于是问题变成一道两难:要 RL 的泛化与抗遗忘,还是要 SFT 吃离线专家数据的能力?
1.3 本文的思路:不动损失函数,改数据分布
已有的弥合方案大多在"改学习目标"上做文章:给 SFT 加重要性采样权重、加 KL 正则,或者把专家数据塞进 GRPO 的上下文里当提示。本文反其道而行之。
损失函数一个字不改,改的是数据分布。
既然 SFT 学不好是因为专家数据"太不像模型自己写的",那就把专家轨迹采样改造一番:保留其正确性与信息量,但把措辞、结构逐步推向基座模型自己的表达习惯。改造后的数据仍是 off-policy 的特权信息,却更"可学"。作者把这套操作命名为投影采样(projection sampling),核心工具是统计学里的老朋友,MCMC。
flowchart LR
    A["离线专家轨迹 π_data"] -->|"投影采样(k 步 MCMC)"| B["中间分布 π_k"]
    B -->|"继续采样"| C["目标分布 p_C"]
    D["基座模型分布 p"] -.对齐 KL 距离.-> C
把"离策略的金子"铸成"在策略的货币",SFT 就能花得比 RL 还好。 论文在化学、数学推理和医疗问答三类任务上验证了这一点:采样改造后的 SFT 往往比 RL 与自蒸馏基线泛化更好、遗忘更少。
2. 目标分布:信息等价且最像模型的数据
2.1 等价类:什么算"信息还在"
先把"改写但不改意思"说严格。给定一条专家轨迹 $\mathbf{x}_i$,定义一个等价类 $\mathcal{C}$:所有与 $\mathbf{x}_i$ “语义等价"的轨迹构成的集合。什么是语义等价,按任务定义。
- 数学与科学推理:凡是利用了专家轨迹中的关键信息、最终答案正确的轨迹都算等价;
- 事实学习:必须包含与专家轨迹相同的事实内容(由自动评分器判定)。
理论上等价关系是先验假设的;实践中它就是"任务相关的正确性判定”。记 $\mathcal{P}_{\mathcal{C}}$ 为只输出等价类内轨迹的全部分布(出了 $\mathcal{C}$ 概率必须为 0),专家数据集本身来自某个任意分布 $q \in \mathcal{P}_{\mathcal{C}}$。
2.2 信息投影:问题的形式化
于是"找一份信息量不变、但最好学的数据"可以写成一个变分问题:在所有与专家信息等价的分布中,找离基座模型 $p$ 最近的那个:
$$ p_{\mathcal{C}} := \arg\min_{\pi \in \mathcal{P}_{\mathcal{C}}} \mathrm{KL}\!\left(\pi \,\|\, p\right) $$这个式子叫信息投影(information projection,Csiszár 1975):在"不许丢信息"的硬约束下,最小化与基座模型的 KL 散度。论文的命题 1 给出了它的闭式解,把基座模型限制在正确轨迹上,再重新归一化:
$$ p_{\mathcal{C}}(\mathbf{x}) = \frac{p(\mathbf{x}) \cdot \mathbf{1}(\mathbf{x} \in \mathcal{C})}{\sum_{\mathbf{x}^{\prime}} p(\mathbf{x}^{\prime}) \cdot \mathbf{1}(\mathbf{x}^{\prime} \in \mathcal{C})} $$其中 $\mathbf{1}(\cdot)$ 是指示函数。直觉非常干净。基座模型自己怎么说话,数据就尽量怎么写;唯一的约束是必须留在正确答案的等价类里。命题 1 的证明只需一行观察,对任意 $\pi \in \mathcal{P}_{\mathcal{C}}$,$\mathrm{KL}(\pi \| p)$ 与 $\mathrm{KL}(\pi \| p_{\mathcal{C}})$ 只差一个与 $\pi$ 无关的常数 $\log Z$,于是最小值点唯一落在 $p_{\mathcal{C}}$ 上。
2.3 如果基座够强:拒绝采样就够了吗
这一点也值得一提。如果基座模型自己就能可靠地采出正确轨迹,那么从 $p_{\mathcal{C}}$ 采样有个土办法:拒绝采样,反复采样,丢掉错的,留下对的。这本身已经接近一种简陋的 on-policy RL。
本文关心的是拒绝采样失效的区域:专家轨迹对基座模型来说太难,自己采根本采不到。这时任务变成:给定一个任意的专家分布 $q$(数据集),能否用算法把它的样本一步步演化成 $p_{\mathcal{C}}$ 的样本? 接下来出场的是 MCMC。
3. 投影采样:用 MCMC 把数据"挪"过来
3.1 轻量科普:Metropolis-Hastings
Metropolis-Hastings(MH)是 MCMC 家族最经典的算法,用来从难以直接采样的分布里抽样本。它的玩法像一场"有原则的改稿":
- 手上有一个当前版本 $\mathbf{x}^i$;
- 用提议分布 $\kappa(\mathbf{x} \mid \mathbf{x}^i)$ 生成一个修改稿 $\mathbf{x}$;
- 按接受率决定要不要换:目标分布觉得修改稿更好,就换;否则留用原稿;
- 重复多步,得到一串样本。当步数趋于无穷时,样本分布收敛到目标分布。
接受率的形式是 MH 的灵魂,它保证了收敛性:提议是"不讲武德"的也可以,接受率会自动校正偏差。
3.2 目标分布的闭式:信息保持的提议分布
直接在 LLM 上跑 MH 有两个坑:一是目标分布 $p_{\mathcal{C}}$ 的归一化常数不知道;二是提议若把轨迹改出等价类,信息就丢了。论文的处理很漂亮。要求提议分布 $\kappa_{\mathcal{C}}$ 本身只在等价类内活动(信息保持),于是接受率里的指示函数与归一化常数同时消掉:
$$ A(\mathbf{x}, \mathbf{x}^i) = \min\left\{1, \frac{p(\mathbf{x}) \cdot \kappa_{\mathcal{C}}(\mathbf{x}^i \mid \mathbf{x})}{p(\mathbf{x}^i) \cdot \kappa_{\mathcal{C}}(\mathbf{x} \mid \mathbf{x}^i)}\right\} $$式子各项的含义如下。
- $p(\mathbf{x}) / p(\mathbf{x}^i)$:基座模型眼里修改稿与原稿的相对似然,越高越该换;
- $\kappa_{\mathcal{C}}(\mathbf{x}^i \mid \mathbf{x}) / \kappa_{\mathcal{C}}(\mathbf{x} \mid \mathbf{x}^i)$:提议的对称性校正,防止提议分布"只会往某一个方向改"造成偏移。
命题 2 保证:带信息保持提议、以基座模型 $p$ 为目标跑 MH,与带普通提议、以 $p_{\mathcal{C}}$ 为目标跑 MH,完全等价。于是配方成型。从专家轨迹出发,用信息保持的提议反复改写,用上式决定去留,输出就是逐步逼近 $p_{\mathcal{C}}$ 的"boosted"轨迹。
提议分布本身怎么实现?一个被提示的 LLM:给它题目、专家解法和当前的半成品回答,让它"用自己的话接着写,保证逻辑与解法一致、最终答案不变"。它天然锚定专家信息,输出又带着模型自己的表达习惯,正是信息保持与 on-policy 的交叉点。
3.3 KL 单调下降:数据一步步更 on-policy
命题 3 给出了本文最重要的理论保证:记 $\pi_k$ 为初始专家分布 $q$ 经过 $k$ 步 MCMC 后的分布,则
$$ \mathrm{KL}\!\left(\pi_{k+1} \,\|\, p\right) \le \mathrm{KL}\!\left(\pi_k \,\|\, p\right) $$证明思路:MCMC 转移核是马尔可夫映射,由数据处理不等式,对平稳分布 $p_{\mathcal{C}}$ 的 KL 距离单调不增;再利用它与 $\mathrm{KL}(\pi \| p)$ 只差常数,结论直接传递。
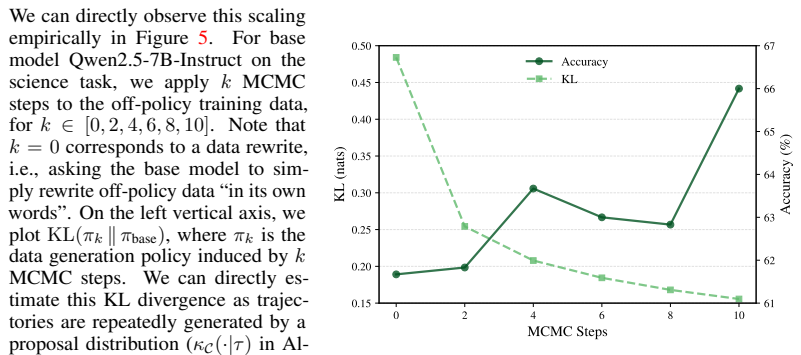
这意味着采样步数 $k$ 成了一个可解释的"on-policy 程度旋钮":$k = 0$ 就是普通的改写(把专家答案用自己的话说一遍),$k$ 越大越接近基座模型自己的分布。这个性质在第 4.4 节的实验里有直接的实证对应。
3.4 LLM 上的工程实现
直接对全长序列跑 MH 不现实:每次提议都要重新生成整条回答,而且高维空间里混合极慢。论文沿用作者此前工作(Karan & Du 2025)的分块方案,完整算法如下:
flowchart TD
    A["以专家轨迹为锚,自回归生成一个块(B=32 token)"] --> B["提议分布 κ_C 改写:随机选位置 m,重采样 m 之后的后缀"]
    B --> C{"按接受率取舍"}
    C -->|"接受"| D["候选成为当前状态"]
    C -->|"拒绝"| E["保留当前状态"]
    D --> F{"该块内 MCMC 步数够了吗"}
    E --> F
    F -->|"否"| B
    F -->|"是"| G["进入下一块,直到完整条轨迹"]
实现有三个要点。
- 分块推进:以 $B = 32$ 个 token 为单位,在序列长度 $T = 1856$ 内逐块采样;每个新块以先前块为条件,由提议分布自回归扩展作为初始状态。
- 块内 MH:每步均匀选一个位置 $m$,用 $\kappa_{\mathcal{C}}$ 重采样 $m$ 之后的后缀作为候选,按接受率取舍,共 $N_{\mathrm{MCMC}} = 10$ 步。
- 工程近似:严格的接受率需要评估反向提议概率,每步要两次前向推理;实现中简化为"候选似然更高就换"。这偏离了标准 MH,更激进地往高似然区跑,但第 4.4 节的 KL 曲线表明它依然保持单调靠近基座模型的良好性质。
4. 实验:SFT 学得比你想的好
4.1 任务、模型与基线
三个任务覆盖了后训练想引入的三类能力:新技能获取、数学推理和开放式专业知识。
| 任务 | 数据集 | 规模(训练/测试) | 基座模型 | 专家轨迹来源 |
|---|---|---|---|---|
| 化学 | SciKnowEval L-3 | 1800 / 600 | Qwen2.5-7B-Instruct、Olmo-3-7B-Instruct | GPT-5 生成 |
| 数学 | MATH 3-5 级 | 8230 / 1024 | Qwen2.5-3B | 数据集自带 |
| 医疗 | HuatuoGPT-o1 SFT | 19704 / 1000 | Qwen2.5-7B-Instruct | 数据集自带 |
基线涵盖三个梯队:原样 SFT;Rewrite SFT(零阶 MCMC,只改写不做 MH,用来分离"改写"与"完整采样"的贡献);以及 on-policy 的强者,自蒸馏 OPSD 与 RL(GRPO、UFT,数学任务)。
4.2 主结果:泛化更好,遗忘更少
下表是三任务主结果的摘要(数值为准确率百分比,“旧均值"为原有能力基准的平均):
| 算法 | 化学·新 | 化学·旧均值 | 数学·新 | 数学·旧均值 | 医疗·新 | 医疗·旧均值 |
|---|---|---|---|---|---|---|
| Base | 34.3 | 59.7 | 31.5 | 42.2 | 35.3 | 59.7 |
| SFT | 61.8 | 52.0 | 24.3 | 38.9 | 44.8 | 35.3 |
| Rewrite SFT | 61.3 | 55.8 | — | — | 45.7 | 51.2 |
| OPSD(on-policy) | 61.8 | 56.8 | 26.7 | 40.4 | 46.6 | 50.1 |
| GRPO(on-policy) | — | — | 45.7 | 41.4 | — | — |
| UFT(on-policy) | — | — | 47.0 | 42.1 | — | — |
| Sampling SFT | 66.0 | 58.6 | 49.5 | 42.0 | 45.8 | 51.6 |
| Sampling SFT + RL | — | — | 54.5 | 43.0 | — | — |
下面几条读数最锋利。
- 化学:采样 SFT 相对基座提升 31.7 个点,比 on-policy 的 OPSD 还高 4.2 个点;MMLU 一项(68.7 对 69.2)毫无损失,旧能力平均只跌 1.10%,是所有基线里忘得最少的,包括号称"抗遗忘"的 OPSD。
- 数学:原样 SFT 全线溃败(MATH 3-5 级从 31.5 跌到 24.3),采样 SFT 却一路反超:最难的 MATH 3-5 级提升 18.0 个点,MATH500 提升 33.7 个点、比最好的 RL 基线还高 26.9 个点。MATH500 这一列尤其说明问题。Rewrite SFT 与 OPSD 在此项都一般,完整 MCMC 采样才是关键。
- 数学 + RL:拿采样 SFT 的检查点再跑 GRPO,整体最强(MATH500 +40.7、GSM8K +25.1),3B 模型逼近 7B-Instruct 的水平,采样 SFT 还是个极好的 RL 起点。
- 医疗:任务本身更开放,OPSD 的新任务准确率以 46.6 对 45.8 略胜,但采样 SFT 的旧能力保留最好(51.6),把原样 SFT 16.3 个点的旧能力损失补回了大半。
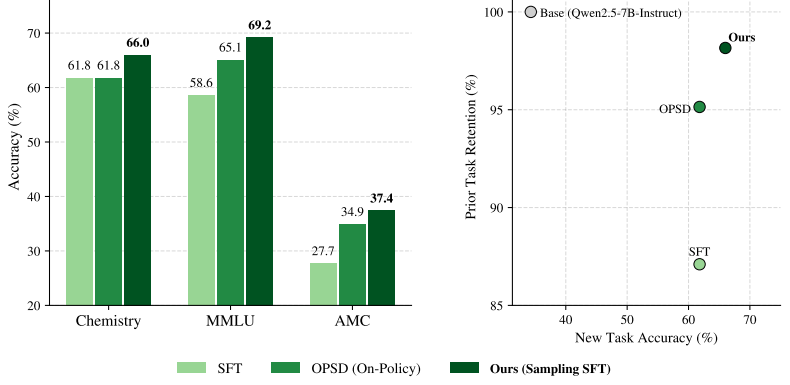
还有一条容易忽略但很关键的消融,数据是按模型定制的。把为 Olmo boosted 的数据拿去微调 Qwen,化学准确率掉到 57.3%,远低于原样 SFT 的 61.8%;用 50% boosted + 50% 原始数据混合,成绩为 62.1%,恰好落在两者之间。这证明起效的是数据分布与学习分布的精准对齐,换个格式改写数据做不到这一点。
4.3 不只是锐化:分布层面的证据
一个自然的怀疑是,把数据往模型自己的分布推,会不会只是把模型"已会的东西"锐化了一遍?论文从两个角度给出否定证据。
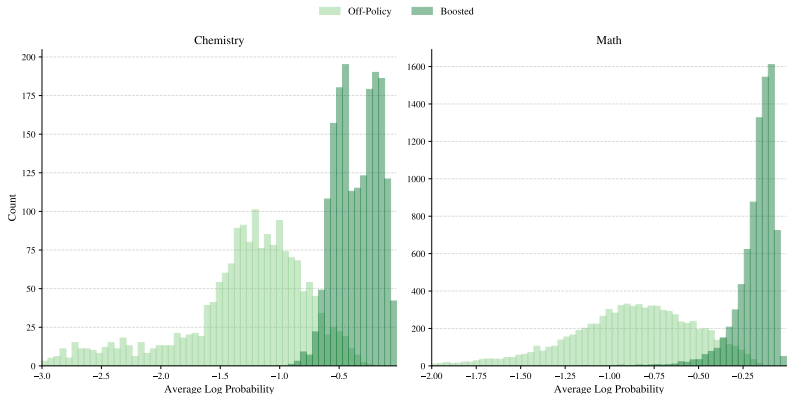
其一,似然直方图。对比专家轨迹与 boosted 轨迹在基座模型下的对数似然分布:boosted 轨迹整体右移(模型觉得"更像自己写的”),同时正确率保留 94% 以上(化学 94.33%、数学 95.33%、医疗 95.86%),信息没丢,可学性上来了。
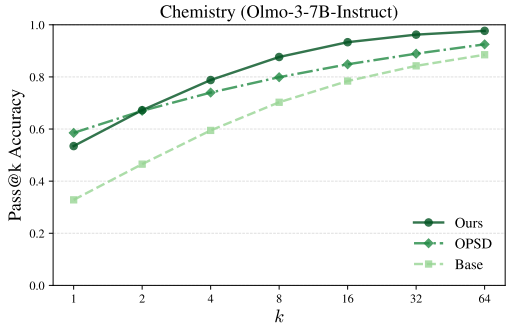
其二,pass@k 曲线。如果只是锐化,微调后的 pass@k 曲线应该在大 $k$ 时收敛回基座模型的水平。实测(Olmo,化学任务)并非如此,直到很大的 $k$,微调模型都保持大幅领先,对 OPSD 也是压着打;更有说服力的是,存在一批基座模型零通过的硬题,微调后通过率升到 53.1% 至 67.2%。这是货真价实的新能力。
4.4 采样算力:一条新的 scaling 轴
命题 3 说采样步数越多、数据越 on-policy。实证完全吻合:在 $k \in \{0, 2, 4, 6, 8, 10\}$ 上,boosted 数据分布与基座模型的 $\mathrm{KL}(\pi_k \| \pi_{\mathrm{base}})$ 单调下降,而对应微调出来的模型准确率单调上升。$k = 0$ 就是 Rewrite SFT,也正是主结果里明显偏弱的那一档。
这给了一个非常工程化的启示,采样时算力可以直接兑换数据质量。数据构建是一次性的投资,换来的是每个训练 epoch 的持续收益。
5. 冷静看局限
这篇论文的叙事很漂亮,但把它的代价摊开看,有五点值得掂量。
- 数据构建的算力账。$T = 1856$、$B = 32$,一条轨迹约 58 个块,每块 10 步 MCMC,每步至少两次 LLM 前向(提议 + 似然评估)。把整份训练集 boost 一遍的推理开销远高于直接 SFT。它本质上是把算力从训练侧挪到了数据侧,是否划算取决于数据集复用多少轮。
- “信息保持"是近似而非保证。理论假设等价关系先验存在;实践里靠最终答案对错或 LLM 评分器(医疗用 GPT-5-mini)判定。实测 boost 后正确率保留 94% 至 96%,仍有 4% 左右的信息损耗,评分器本身的误差还会叠加。
- 贪心近似偏离了标准 MH。实现里"似然更高就换"忽略了提议比校正,严格说不再是从 $p_{\mathcal{C}}$ 精确采样。论文用 KL 单调下降的实证兜底,但理论与实现之间存在一条没有完全闭合的缝。
- 提议分布的能力天花板。$\kappa_{\mathcal{C}}$ 由基座模型自己充当(靠专家轨迹提示引导)。模型太弱时,即便有专家解法参照,改写质量也差,链的混合效果会打折扣;跨模型 boost 数据的失败实验(4.2 节)也说明这套数据与模型强绑定,不能跨模型复用,每个基座模型都得把采样管线重跑一遍。
- 实验规模有限。3B 与 7B 两档模型、单一数据集和单技能注入。在 frontier 规模、多技能混合和长程 Agent 任务上的表现尚无证据。
反过来说,第 1 点与第 4 点也有另一面。数据构建是一次性成本,boost 后的数据还能服务后续 RL;数据与模型强绑定,不妨看作"为每个模型定制可学性"的特性而非缺陷。这些账怎么算,取决于使用场景。
6. 总结与启示
Finetuning with Sampling 提供了一个反直觉但极其清爽的视角:SFT 泛化差、遗忘多,未必是损失函数的错,也可能是数据分布与模型"不对付”。 用信息投影定义"信息不变、最像模型"的理想数据分布,用 Metropolis-Hastings 一步步逼近它,就得到了投影采样,一个让 SFT 在泛化与抗遗忘上正面赢过 RL 与自蒸馏的采样算子。
有三点启示。
- 采样可以是后训练的一等公民。论文把采样抬到"模型原生算子"的高度:它不只服务 SFT,还能为自蒸馏构造更贴近学生分布的教师样本,或在 RL 采不出成功轨迹时模拟 on-policy rollout。在推理时计算(test-time compute)炙手可热的今天,数据时计算(data-time compute)同样是一条值得投入的轴。
- on-policy 是手段不是目的。RL 的好,好在"数据分布离模型不远";把这个性质直接焊进数据里,SFT 的简单稳定与 on-policy 的泛化保留可以兼得。
- 别急着换损失函数。改目标、加正则或调算法,都比"把数据改得更可学"复杂得多。SFT 表现不佳,先看看数据是写给模型看的,还是模型写得出来的。
参考资料
- Karan, A., Chen, S., & Du, Y. (2026). Finetuning with Sampling: SFT Learns Better Than You Think. https://arxiv.org/abs/2610.02140
- 项目主页与代码. https://aakaran.github.io/finetuning_with_sampling/ · https://github.com/aakaran/finetuning-with-sampling
- Karan, A., & Du, Y. (2025). Reasoning with Sampling: Your Base Model Is Smarter Than You Think. https://arxiv.org/abs/2510.14901
- Chu, T., et al. (2025). SFT Memorizes, RL Generalizes: A Comparative Study of Foundation Model Post-Training. https://arxiv.org/abs/2501.17161
- Chen, H., et al. (2025). Retaining by Doing: The Role of On-Policy Data in Mitigating Forgetting. https://arxiv.org/abs/2510.18874
- Guo, D., et al. (2025). DeepSeek-R1: Incentivizing Reasoning Capability in LLMs via Reinforcement Learning. https://arxiv.org/abs/2501.12948
- Csiszár, I. (1975). I-Divergence Geometry of Probability Distributions and Minimization Problems. The Annals of Probability, 3(2), 146–158.